

주문 테이블의 STATUS_CODE CHAR(1)에는 S, D, C가 들어 있습니다. 모델이 C를 완료(complete)로 짐작하면 「지난달 완료 주문 매출」에 취소 주문이 섞여 나옵니다. SQL은 오류 없이 실행되고 숫자만 틀리니 DB도 모델도 실수를 알아채지 못합니다. C가 취소라는 사실은 DDL 어디에도 없고, 그 컬럼에 실제로 들어 있는 값과 짝이 되는 코드 테이블에만 있습니다.
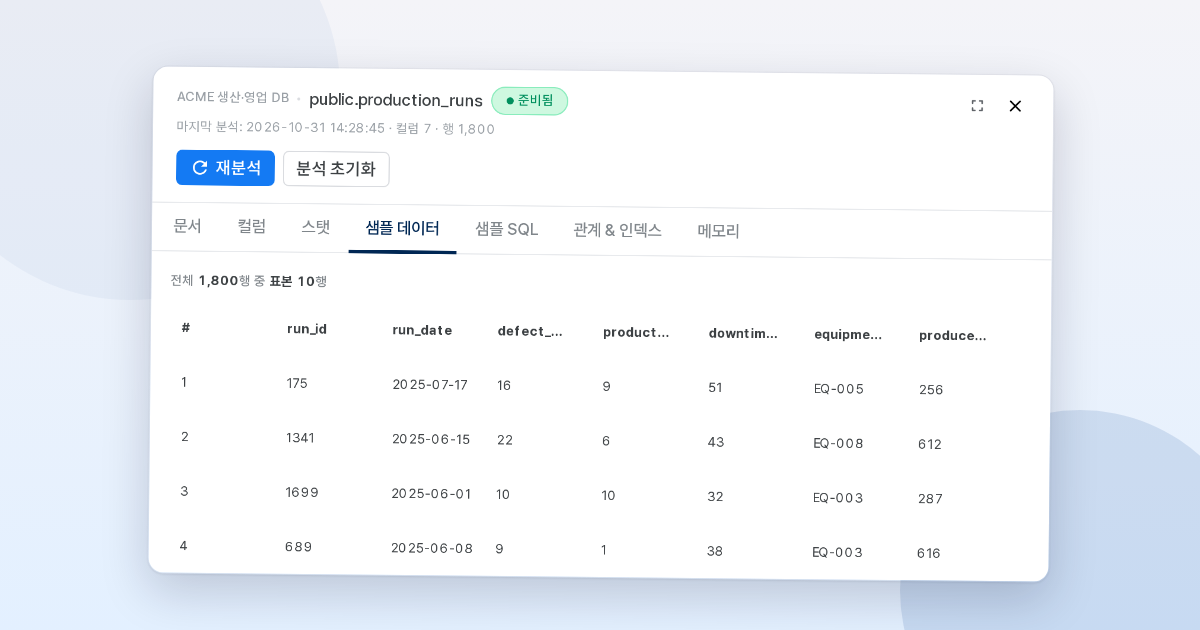
그래서 컬럼의 뜻을 질문보다 먼저 정리해 둡니다. 관리자가 스키마 분석을 돌리면 OwlAI는 테이블마다 DB가 이미 모아 둔 통계·값 분포·샘플 행·실제로 돌던 SQL을 읽고, 분석 에이전트가 뜻이 정해지지 않는 컬럼만 코드 테이블을 열어 확인합니다. 결과는 컬럼마다 사실과 뜻을 나란히 적은 테이블 카드로 저장되고, 채팅은 질문할 때 그 카드를 꺼내 씁니다.
이름으로 짐작한 컬럼은 틀려도 오류가 나지 않는다
업무 DB에서 이름만으로 뜻을 알 수 없는 컬럼은 대개 세 가지 모양입니다.
| 컬럼 | DDL이 말하지 않는 것 | 짐작이 틀리면 |
|---|---|---|
코드 컬럼 STATUS_CODE CHAR(1) |
S·D·C가 배송 중·배송 완료·취소라는 것 |
취소 주문이 완료 매출에 들어갑니다 |
자유 입력 컬럼 REMARK VARCHAR(400) |
상담원이 손으로 적는 메모이고 가장 흔한 값이 마침표 하나라는 것 | 「비고에 '취소'가 들어간 주문」을 세어 취소 건수라고 답합니다 |
선언되지 않은 참조 PROD_TP |
제품 유형 코드 테이블과 이어진다는 것(외래 키 없음) | 코드 값만 나열하거나, 이름이 비슷한 다른 테이블과 조인합니다 |
셋 다 실행은 성공합니다. 문법 오류라면 DB가 거절하고 모델이 고칠 기회가 생기지만, 뜻을 잘못 읽은 SQL은 그대로 답이 됩니다. 막으려면 SQL을 쓰기 전에 모델이 컬럼의 뜻을 알고 있어야 합니다.
질문할 때마다 조사하면 같은 컬럼을 매번 다시 본다
가장 가까운 방법은 질문이 온 뒤에 값을 살펴보는 것입니다. 미리 치를 비용이 없고 늘 지금 값을 보지만, 「S가 뭐지」를 질문마다 다시 조사하는 라운드가 매번 응답 시간에 얹힙니다. 모델이 조사를 건너뛰고 이름으로 짐작해도 막을 장치가 없습니다.
다른 방법은 데이터 프로파일링처럼 원천 테이블을 직접 세는 것입니다. 컬럼마다 COUNT(DISTINCT)와 GROUP BY를 돌리면 정확하지만, 수억 행 테이블에서는 컬럼마다 전체 스캔이 되고 그 부하가 운영 DB에 걸립니다. 통계가 없다고 ANALYZE나 DBMS_STATS로 새로 만들면 원천 DB의 상태를 바꾸는 쓰기가 됩니다.
그래서 뜻을 정리하는 일은 질문 전에 한 번 하고, 재료는 DB가 이미 모아 둔 것에서 읽기로 했습니다.
분석은 DB가 이미 모아 둔 통계만 읽는다
분석의 첫 단계는 판단 없이 사실만 모읍니다. 재료마다 읽는 곳이 정해져 있습니다.
| 재료 | 읽는 곳 |
|---|---|
| 컬럼·타입, 키와 제약 조건, 인덱스, 테이블·컬럼 주석 | 카탈로그 |
| 행 수, 고유 값 수, NULL 비율, 최솟값·최댓값 | 옵티마이저 통계 |
| 값 분포(자주 나오는 값과 그 행 비율) | 옵티마이저 히스토그램. PostgreSQL pg_stats의 최빈값, Oracle의 FREQUENCY·TOP-FREQUENCY·HYBRID, Tibero의 FREQUENCY, MySQL의 singleton, MariaDB JSON_HB의 인기값 |
| 통계 상태 | 마지막 수집 시각과 낡았는지 여부. 수집된 적이 없는지, 권한이 없어 읽지 못했는지를 구분합니다 |
| 이 테이블에 실제로 돌던 SQL | PostgreSQL pg_stat_statements, MySQL·MariaDB performance_schema, Oracle·Tibero V$SQL |
값 분포는 컬럼당 50개까지 저장하고, 고유 값을 전부 담았는지와 실린 값이 전체 행의 몇 %를 덮는지를 함께 둡니다. 히스토그램이 없는 컬럼은 값 분포를, 통계가 없는 칸은 그 칸을 0으로 채우지 않고 비워 둡니다. 모델이 「0」과 「모른다」를 구분해야 하기 때문입니다. 실제 SQL에서는 OwlAI가 보낸 문장을 빼고, 남은 SQL은 이 테이블을 어떻게 조인하고 거르는지 보여 주는 예시로 씁니다.
뜻이 정해지지 않는 컬럼만 에이전트가 값을 확인한다
모은 사실은 테이블 분석 에이전트의 입력에 처음부터 실립니다. 주석·키·통계·값 분포·통계 상태와 샘플 5행, 실제 SQL 5개입니다. 에이전트는 채팅과 같은 에이전트 루프(「에이전트 루프는 하나만 두고, 기능별 동작은 훅으로 끼운다」)에서 돌고, 쓸 수 있는 도구는 읽기 전용 셋입니다.
| 도구 | 하는 일 |
|---|---|
| 참조 테이블 읽기 | 코드 테이블 같은 참조 대상의 행을 읽어 코드와 라벨의 짝을 확인합니다 |
| 조건 샘플 | 「C인 행은 취소 주문이다」 같은 가설을 WHERE 조건으로 걸어 확인합니다 |
| 테이블 목록 | 연결 계정이 볼 수 있는 테이블 이름 전체를 돌려줍니다 |
값을 세는 도구는 두지 않았습니다. 값 분포는 이미 입력에 있고, 도구가 GROUP BY를 돌리면 첫 단계가 피한 전체 스캔이 되돌아옵니다. 대상 테이블은 도구에 고정돼 있어 에이전트는 컬럼과 조건만 넘기고, SQL을 보내는 두 도구는 행 수 상한을 붙여 실행합니다. 한 테이블에 쓸 수 있는 도구 호출은 모두 40회입니다.
시스템 프롬프트는 카탈로그로 뜻이 정해지지 않는 컬럼에만 도구를 쓰라고 지시합니다. 짝이 될 코드 테이블은 테이블 목록에서 실제 이름을 확인한 다음 읽습니다. 목록에 없는 이름을 넘기면 참조 테이블 읽기 도구가 SQL을 보내기 전에 거절합니다.
에이전트는 정해진 모양의 결과 하나를 냅니다.
| 항목 | 담는 것 |
|---|---|
| 목적 | 테이블의 목적과 역할, 두세 문장 |
| 컬럼 설명 | 컬럼마다 한 줄. 코드 컬럼이면 대표 코드의 뜻을 넣습니다 |
| 테이블 역할 | 마스터, 시점이 있는 거래·이벤트, 코드 테이블, 다대다 연결, 뷰 가운데 하나 |
| 코드 테이블 정보 | 이 테이블이 코드 테이블이면 코드 컬럼과 라벨 컬럼 |
| 코드 풀이 | 이 테이블의 코드 컬럼마다 코드→뜻 짝과 출처 코드 테이블 |
| 오용 주의 컬럼 | 이름과 달리 분류·필터에 쓰면 안 되는 컬럼과 그 이유 |
| 추정 조인 | 외래 키로 선언되지 않은 조인 관계와 근거, 확신도(낮음·중간·높음). 「높음」은 값 겹침이나 참조 테이블 확인으로 검증한 것에만 씁니다 |
저장하기 전에는 코드가 한 번 더 거릅니다. 코드 테이블 정보가 가리킨 컬럼이 실제로 없으면 버리고, 추정 조인 가운데 이미 선언된 외래 키와 같은 것은 뺍니다. 매번 같은 답이 나오는 확인이라 모델에게 맡기지 않습니다.
카드 한 장에 컬럼마다 사실과 뜻을 나란히 싣는다
마지막 단계는 모은 사실과 에이전트의 결과를 합쳐 테이블 카드를 만듭니다. 카드는 컬럼마다 타입과 키 역할, NULL 비율·고유 값 수·값 범위를 한 줄로 적고, 그 아래에 고객이 DB에 단 주석, 에이전트가 쓴 뜻, 자주 나오는 값을 붙입니다.

자주 나오는 값은 고유 값 전부가 20개 이하이면 모두 싣습니다. 아니면 상위 10개와 그 값들이 덮는 행 비율을 싣고 「다른 값도 있다」고 적어, 모델이 목록 밖의 값을 없다고 단정하지 않게 합니다. 카드 머리에는 목적과 역할, 행 수, 통계 상태가 오고, 통계가 수집된 적이 없으면 행 수와 NULL 비율을 0이 아니라 모르는 값으로 읽으라고 적습니다.
같은 카드를 두 곳에서 씁니다. 텍스트로 렌더한 카드는 테이블 검색의 대상이 되고(「테이블을 잘못 고른 SQL도 실행된다, 검색이 후보부터 좁힌다」), 테이블 카드 도구는 같은 카드를 구조 그대로 모델에 돌려줍니다. 그래서 검색에서 본 내용과 카드를 열어 본 내용이 어긋나지 않습니다.
채팅은 코드 풀이를 힌트로만 쓰고 코드 테이블을 조인한다
카드의 코드 풀이는 분석 시점의 샘플입니다. 분석 뒤에 코드 테이블에 새 코드가 들어오거나 라벨이 바뀌면 카드는 옛 내용을 들고 있습니다. 그래서 채팅 시스템 프롬프트는 코드 풀이로 코드를 직접 풀지 말라고 지시합니다. 결과에 코드 컬럼이 나오면 코드 테이블을 LEFT JOIN해 라벨을 함께 내고, 「배송 중인 주문」처럼 라벨로 거를 때도 코드 테이블의 라벨 컬럼에 조건을 겁니다.
이 조인을 쓰려면 주문 테이블의 STATUS_CODE가 ORDER_STATUS 테이블로 이어진다는 경로가 있어야 합니다. 외래 키가 없어도 에이전트가 두 컬럼의 값이 모두 겹치는 것을 확인했으면 추정 조인으로 기록하고 확신도를 「높음」으로 둡니다.
오용 주의 컬럼도 같은 식으로 쓰입니다. REMARK에서 가장 흔한 값이 .이고 나머지가 손으로 적은 문장이면, 에이전트는 이 컬럼을 오용 주의 목록에 올리고 「주문 상태는 STATUS_CODE에 있다」는 이유를 붙입니다. 채팅 시스템 프롬프트는 이 목록의 컬럼에 WHERE나 GROUP BY를 걸지 말고 가리킨 컬럼을 쓰라고 지시합니다.
여러 테이블을 함께 봐야 하는 판정은 DB 요약이 내린다
테이블 분석 에이전트는 테이블 하나만 봅니다. 어떤 테이블이 다른 테이블의 백업·스테이징 사본이나 파티션인지는 여러 테이블을 함께 봐야 알 수 있어서, 테이블 분석이 끝난 뒤 DB 요약이 판정해 각 테이블의 분석 결과에 적어 둡니다. 검색은 이 판정으로 사본을 본 테이블 뒤로 보냅니다(「테이블을 잘못 고른 SQL도 실행된다, 검색이 후보부터 좁힌다」).
DB 요약은 코드 테이블의 값도 모읍니다. 행 수 통계가 1,000행 이하인 코드 테이블만 코드와 라벨을 DISTINCT로 전부 읽고, 그보다 크거나 행 수를 모르면 읽지 않습니다. 모은 값은 그 코드 테이블의 카드에 실립니다.
분석 비용은 테이블 수에 비례한다
테이블마다 에이전트 루프가 한 번 돌기 때문에 비용은 테이블 수에 비례합니다. 실운영 환경에서 2026년 10월에 돌린 분석 작업 14건(약 520개 테이블)을 보면 테이블 하나에 입력 1만 5천 토큰 안팎(그 가운데 절반가량이 프롬프트 캐시 적중)과 출력 1천 토큰 안팎이 들었습니다. 가장 큰 요청은 270여 개 테이블을 16분 남짓에 끝냈습니다. 한 요청 안의 테이블은 기본 5개씩 동시에 분석하고, 이 값은 설치 설정 analyze.parallelism으로 바꿉니다.
그래서 범위는 관리자가 정합니다. 데이터베이스 화면에서 필요한 테이블만 골라 분석하고, 실패한 것만 다시 돌릴 수 있습니다. 분석의 조회는 모두 읽기 전용이고 채팅과 같은 시간 예산과 취소 경로를 탑니다(「읽기 전용과 쿼리 취소는 DB 서버에 닿아야 한다」). OwlDB로 연결한 DB에서는 분석 조회도 OwlDB를 거쳐, 스탠바이 노드가 있으면 운영 노드를 건드리지 않습니다(「AI 조회를 실행할 노드는 등록할 때가 아니라 실행할 때 고른다」).
설계에서 고른 것
값 분포는 원천에서 세지 않고 DB의 통계에서 읽습니다. 운영 DB에 전체 스캔을 걸지 않는 대신, 히스토그램이 없는 컬럼은 값 분포가 비고 있는 값도 통계의 샘플 근사입니다. 엔진마다 기본 수집 범위도 다릅니다. Oracle의 기본 설정은 WHERE에 쓰인 컬럼에만 히스토그램을 만들고, MySQL은 컬럼마다 ANALYZE TABLE … UPDATE HISTOGRAM을 해야 생깁니다. 그래서 카드는 값 분포가 전부가 아니면 그렇다고 적고, 비어 있는 컬럼은 에이전트가 샘플 행과 조건 샘플로 확인합니다.
코드 풀이는 저장하되 채팅이 답에 쓰지 않게 했습니다. SQL에 조인이 하나 더 붙는 대신, 분석 뒤에 추가된 코드도 지금 라벨로 나옵니다.
분석 결과는 재분석 전까지 그대로입니다. 컬럼이 늘거나 바뀐 테이블은 스키마 점검이 찾아 표시하고, 관리자가 그 테이블만 다시 분석합니다(「DB가 바뀌면 분석은 낡는다, 바뀐 테이블만 찾아 다시 분석한다」). 그 사이에는 예전 카드가 쓰인다는 것이 이 선택의 대가입니다.
코드처럼 생긴 컬럼 이름이 많고 외래 키 선언이 드물고 비고 같은 자유 입력 컬럼이 섞인 업무 DB라면 이 방식이 맞습니다. 그런 DB를 연결한다면 분석을 돌리기 전에 원천 DB에서 통계와 히스토그램이 수집되고 있는지부터 봅니다. 분석이 읽는 값 분포는 그 통계만큼만 정확합니다.
어떤 문제를 해결하나요?
정형 데이터와 NL2SQL의 다른 글
엔지니어링 노트 · 정형 데이터와 NL2SQL
테이블을 잘못 고른 SQL도 실행된다, 검색이 후보부터 좁힌다
테이블이 수천 개인 업무 DB에는 주문 테이블 옆에 ORDMSTBAK, ORDMST202312 같은 백업·작업용 사본이 흔히 함께 남아 있습니다.
엔지니어링 노트 · 정형 데이터와 NL2SQL
부서마다 다른 매출 계산식, 승인된 용어집 정의만 질문 앞에 싣는다
「지난달 매출」을 물으면 영업팀은 수주 금액을, 재무팀은 반품을 뺀 세금계산서 발행 금액을 떠올립니다.
엔지니어링 노트 · 정형 데이터와 NL2SQL
읽기 전용과 쿼리 취소는 DB 서버에 닿아야 한다
OwlAI의 SQL 실행 도구는 모델이 쓴 SQL을 고객의 운영 DB에서 실행합니다. 이때 클라이언트 쪽에서 건 제한은 걸린 것처럼 보여도 DB 서버에 닿지 않는 경우가 있습니다.