「30일 넘게 처리되지 않은 주문이 몇 건인가」를 문서 검색(RAG)으로 풀면, 모델은 검색에 걸린 조각 몇 개 안의 주문만 세고 그 수를 총계로 답합니다. 검색은 질문과 비슷한 조각을 돌려줄 뿐, 조건에 맞는 행을 전부 돌려주지 않기 때문입니다. 숫자가 틀려도 답의 모양은 멀쩡해서, 읽는 사람은 틀린 줄 모릅니다.
그래서 건수·합계·기간별 추이처럼 행을 세고 묶어야 나오는 답은 원천 DB에 SQL로 묻게 했습니다. 모델은 DB를 다루는 도구 여덟 개를 문서 검색과 같은 도구 목록에서 골라 씁니다. 받은 행 수를 총계로 착각하지 않도록, 결과가 잘렸으면 실행 도구가 그 사실을 결과에 적어 돌려줍니다. 이 글은 이 도구들을 어떻게 나눴는지, 잘린 결과를 어떻게 알리는지, 문서와 DB가 함께 필요한 질문을 한 턴에 어떻게 푸는지 다룹니다.
검색이 돌려주는 조각 몇 개로는 총계를 셀 수 없다
업무 질문 가운데 「출장비 정산 기준이 어떻게 되나」는 답이 문서에 문장으로 적혀 있습니다. 그 문장을 찾아 모델에 붙이면 되니 RAG가 잘 푸는 질문입니다.
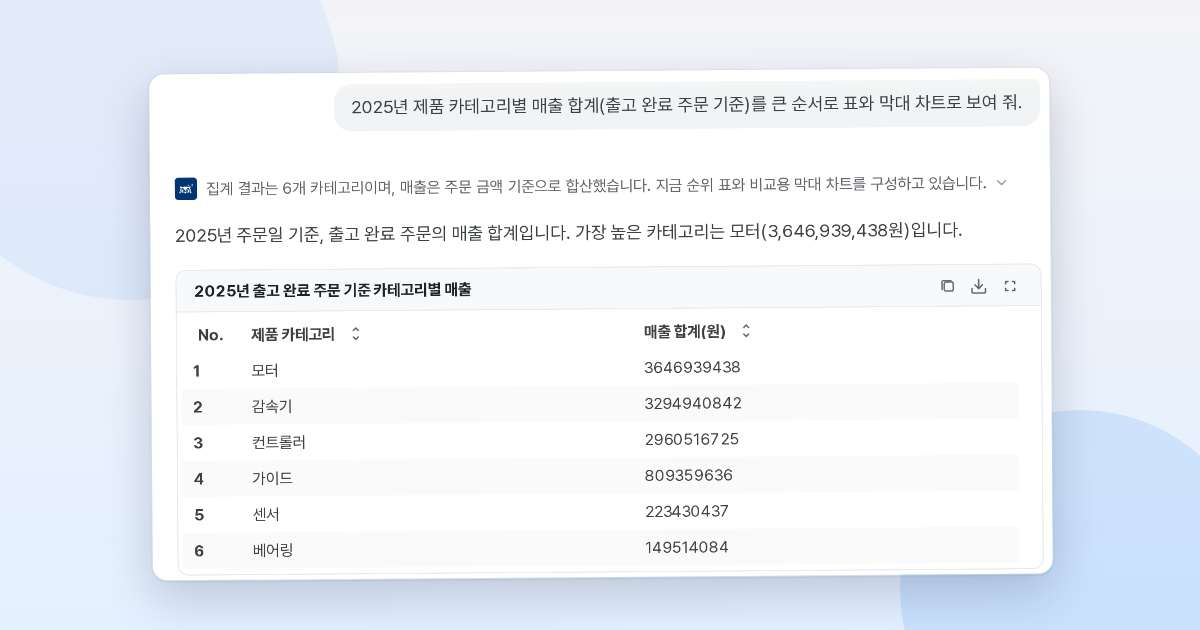
「지난달 지역별 매출」, 「30일 넘게 처리되지 않은 주문 건수」는 다릅니다. 답이 어느 문서에도 문장으로 적혀 있지 않습니다. 조건으로 행을 고르고, 세고, 묶어야 비로소 숫자가 생깁니다. 임베딩 검색은 질문과 가까운 조각을 위에서부터 k개 돌려줍니다. 조건에 맞는 주문이 300건이어도 상위 k개 조각에 12건이 걸렸다면 모델은 「총 12건」이라고 답합니다. 모델은 검색 결과 밖에 행이 더 있는지 알 수 없습니다.
테이블을 내보내 색인하면 시점과 권한도 어긋난다
DB 데이터를 RAG로 풀려는 흔한 방법은 테이블을 주기적으로 내보내 텍스트로 바꾸고 문서처럼 색인하는 것입니다. 이미 있는 문서 검색 파이프라인을 그대로 쓸 수 있고, 질문할 때 원천 DB에 부하를 주지 않습니다. 그런데 이 방법은 총계 말고도 세 가지가 어긋납니다.
| 어긋나는 것 | 일어나는 일 |
|---|---|
| 시점 | 색인은 내보낸 순간의 값입니다. 주문 상태처럼 하루에도 여러 번 바뀌는 값은 다음 내보내기까지 틀린 채로 남습니다. |
| 집계 | 합계·평균·기간별 추이는 행 전체를 훑어야 나옵니다. 모델이 직접 계산하려면 행을 전부 컨텍스트에 실어야 하는데, 수만 행은 들어가지 않습니다. |
| 권한 | 원천 DB는 계정마다 볼 수 있는 테이블을 나눠 둡니다. 행을 텍스트로 풀어 한 색인에 넣으면 그 구분을 문서 단위로 다시 만들어야 합니다. |
네 가지 모두 원천 DB가 이미 잘하는 일입니다. 그래서 DB에 있는 답은 DB에 직접 묻습니다.
모델은 테이블을 찾고 컬럼을 확인한 뒤 SQL을 실행한다
DB를 다루는 도구는 「SQL 실행」 하나가 아닙니다. 모델이 단계마다 골라 쓰도록 여덟 개로 나눴습니다.
| 도구 | 하는 일 |
|---|---|
| DB 목록 | 연결된 DB와 분석 상태를 돌려줍니다. |
| DB 프로필 | DB 하나에 어떤 업무 데이터가 있는지 알려 줍니다. 어느 DB를 볼지 애매할 때 씁니다. |
| 테이블 검색 | 질문과 관련된 테이블 후보를 의미로 찾습니다. 여러 DB를 한 번에 찾을 수 있습니다. |
| 테이블 이름 목록 | DB 하나에서 분석을 마친 테이블 이름을 돌려줍니다. |
| 테이블 카드 | 테이블 하나의 컬럼·키·통계·코드 값·조인 경로와 각 컬럼의 뜻을 한 장으로 돌려줍니다. |
| 조인 경로 | 테이블 사이의 조인 경로를 돌려줍니다. DB에 선언된 외래 키와 분석이 추정한 관계를 나눠서 줍니다. |
| 실행 계획 | 읽기 전용 SQL의 실행 계획을 보여 줍니다. |
| 읽기 전용 실행 | 읽기 전용 SQL 한 문장을 원천 DB에서 실행합니다. |
시스템 프롬프트는 테이블 검색 → 테이블 카드 → (무거워 보이면) 실행 계획 → 읽기 전용 실행 순서를 기본으로 적어 둡니다. SQL을 쓰기 전에는 쓰려는 테이블마다 테이블 카드로 컬럼을 확인하라고 지시합니다. 모델이 컬럼 이름을 짐작해 쓰면 SQL은 오류로 끝나거나, 더 나쁘게는 이름이 비슷한 다른 컬럼으로 실행됩니다.
첫 턴의 입력에는 사용자가 조회할 수 있는 DB의 이름이 MariaDB, Tibero 같은 엔진 종류와 함께 실립니다. 모델은 엔진 종류를 보고 날짜 함수와 인용 부호를 그 DB의 SQL 방언에 맞춥니다.
테이블 카드의 재료는 미리 만들어 둡니다. 관리자가 스키마 분석을 돌리면 테이블마다 컬럼의 뜻, 코드 값, 선언되지 않은 조인 관계가 저장됩니다(「컬럼의 뜻은 DDL에 없다, 질문 전에 값을 읽어 둔다」). 숫자는 미리 저장하지 않습니다. 미리 정리해 두는 것은 「어느 테이블의 어느 컬럼에 무엇이 있는가」이고, 「지금 값이 얼마인가」는 질문할 때마다 원천 DB에서 읽습니다.
결과가 잘렸으면 실행 도구가 그 사실을 알린다
DB에 직접 물어도 총계가 틀릴 수 있습니다. 모델이 SQL에 LIMIT 200을 붙여 200행을 받고 「총 200건」이라고 답하는 경우입니다. 검색 조각을 총계로 읽는 실수와 모양이 같습니다.
그래서 읽기 전용 실행 도구는 결과에 잘림 여부를 함께 돌려줍니다. 다음 가운데 하나라도 걸리면 잘린 것으로 표시합니다.
| 상한 | 동작 |
|---|---|
| 도구의 행 상한 | 기본 500행입니다. 모델이 더 큰 값을 주면 설치의 최대값(dbConnection.maxRowLimit, 기본 10,000)까지 낮춥니다. 실행기는 상한보다 한 행을 더 읽어 보고, 그 행이 오면 잘림으로 표시합니다. |
| SQL 자신의 상한 | SQL의 LIMIT·FETCH FIRST만큼 행이 왔으면 잘림으로 표시합니다. DB가 그 자리에서 멈추므로 한 행 더 읽어 보는 방법으로는 알 수 없어서 따로 셉니다. COUNT(*)만 하는 SQL처럼 한 행만 나올 수 있는 문은 제외합니다. |
| 결과 크기 | 셀의 누적 크기가 설치의 상한(dbConnection.resultMaxBytes, 기본 16MB)을 넘으면 그 뒤 행은 받지 않고 잘림으로 표시합니다. |
도구 설명은 이 표시를 어떻게 읽을지 정해 둡니다. 결과에 온 행 수는 받은 행의 수일 뿐 총계가 아니고, 몇 건인지 답하려면 SQL에서 COUNT(*)나 GROUP BY로 다시 세라고 적습니다. 모델에게 「행 수를 총계로 말하지 말라」고만 지시하면 모델은 언제 잘렸는지 알 수 없습니다. 잘렸는지는 실행기가 판정할 수 있는 사실이라 실행기가 판정합니다. 결과 전체가 필요한 요청은 원본을 파일로 넘기는 장치가 맡습니다(「조회 결과는 모델이 다시 받아 적지 않게 파일 경로로 넘긴다」).
기준은 문서에서, 숫자는 DB에서 한 턴에 가져온다
문서 검색과 DB 도구는 같은 루프의 같은 도구 목록에 있습니다(「에이전트 루프는 하나만 두고, 기능별 동작은 훅으로 끼운다」). 그래서 한 질문이 둘을 다 필요로 하면 한 턴 안에서 이어 씁니다. 턴은 질문 하나를 받아 답을 내기까지의 한 번의 질의응답입니다.
「규정상 장기 미처리 기준을 넘긴 주문이 몇 건인가」를 물으면 모델은 먼저 문서 검색으로 규정에서 「장기 미처리」의 기준을 찾습니다. 기준이 「접수 후 30일」이면 테이블 검색으로 주문 테이블을 찾고, 테이블 카드로 접수일과 처리 상태 컬럼을 확인합니다. 그다음 그 기준을 조건으로 넣은 COUNT(*) SQL을 읽기 전용 실행 도구로 실행합니다. 답에는 문서에서 온 기준과 DB에서 온 건수가 함께 실립니다. 사용자는 답 위의 사고 과정에서 단계마다 도구에 보낸 입력과 받은 결과를 열어 볼 수 있습니다.

권한과 범위는 문서와 DB가 각자의 기준으로 거른다
두 도구 묶음은 루프를 함께 쓰지만 권한은 따로 거릅니다. 문서는 문서 모음마다 연 권한으로, DB는 역할에 허용한 범위로 거릅니다. 직접 연결한 DB는 DB 단위로, OwlDB로 연결한 DB는 테이블 단위까지 엽니다. 검색에 걸렸지만 권한 밖인 테이블과 문서는 이름만 따로 돌려줍니다. 모델은 그 이름으로 「자료는 있지만 볼 권한이 없다」고 답하고, 그 테이블에 SQL을 시도하지 않습니다. 권한 없는 DB도 첫 턴 입력에 이름만 실립니다. 사용자가 그 DB를 물으면 모델이 없는 DB로 오해하지 않고 권한이 없다고 답하게 하려는 것입니다.
사용자가 질문에서 특정 DB나 문서 모음을 멘션하면 그 턴의 조회는 그 범위에 묶입니다. 멘션한 DB에서 답이 나오지 않아도 모델은 다른 DB의 행을 읽지 않습니다. 메타데이터만 보는 테이블 검색으로 다른 DB의 후보를 찾아 사용자에게 어느 쪽을 볼지 묻고, 사용자가 고른 DB만 조회합니다. 범위 밖 DB로 가는 테이블 카드와 실행 호출은 도구가 거절합니다.
설계에서 고른 것
색인 대신 원천 DB에 묻기로 한 대가는 원천 DB의 부하입니다. 내보낸 사본을 검색하면 원천 DB는 질문이 있었는지도 모르지만, 지금 값으로 답하려면 질문마다 원천 DB에 쿼리가 갑니다. 그래서 조회 하나에 시간 예산(timeouts.dbQuerySeconds, 기본 600초)을 두고, DB 하나에 동시에 도는 실행을 dbConnection.perDbConcurrency(기본 4)로 묶고, 접속 계정은 조회 권한만 있는 계정을 쓰게 합니다(「읽기 전용과 쿼리 취소는 DB 서버에 닿아야 한다」).
기본 행 상한을 500으로 둔 것도 고른 값입니다. 상한을 높이면 잘리는 경우는 줄지만, 받은 행은 모두 모델의 컨텍스트를 차지합니다. 건수와 합계는 SQL이 세게 하고, 모델에게는 판단에 필요한 만큼만 돌려줍니다.
채팅은 스키마 분석을 마친 테이블만 답에 씁니다. 테이블 카드가 있어야 컬럼을 확인하고 SQL을 쓸 수 있기 때문입니다. 대가로 새로 만든 테이블은 분석하기 전까지 답에 쓰이지 않습니다. 이 공백은 스키마 점검이 새 테이블을 찾아 「미분석」으로 보여 주는 것으로 줄입니다(「DB가 바뀌면 분석은 낡는다, 바뀐 테이블만 찾아 다시 분석한다」).
도구를 여덟 개로 나누면 SQL 하나를 실행하기까지 라운드가 몇 번 더 돕니다. 테이블 목록과 컬럼 전체를 프롬프트에 미리 실으면 라운드는 줄지만, 테이블이 수천 개인 DB는 프롬프트에 들어가지 않습니다. 업무 시스템의 DB를 직접 연결하려는 환경이라면 시간 예산, 동시 실행 상한, 읽기 전용 계정 세 가지를 먼저 정해 두고 연결하는 것이 순서입니다.
어떤 문제를 해결하나요?
인사이트 · 왜 업무용 AI인가
지금 재고를 물으면 AI 챗봇은 최신 숫자로 답할까
영업 담당자가 사내 AI 챗봇에 "A 제품 지금 재고 몇 개야?"라고 묻습니다. 챗봇은 지난달 말에 올라온 재고 보고서를 찾아 거기 적힌 숫자로 답합니다.
인사이트 · 왜 업무용 AI인가
여러 시스템에 흩어진 자료를 AI가 한 번에 모아 줄 수 있을까
"이번 분기 연체 90일을 넘긴 거래처 가운데 규정상 추심 대상인 곳을 뽑고, 담당자별로 정리해 줘." 영업관리팀에서 흔히 나오는 요청입니다.
인사이트 · 왜 업무용 AI인가
ChatGPT는 그렇게 똑똑한데, 왜 회사 일에는 못 쓸까
범용 AI 서비스에 "이번 달 우리 지점별 매출이 어떻게 돼?"라고 물으면 답은 금방 나옵니다. 문장은 매끄럽고 표까지 그려 줍니다. 그런데 숫자를 들여다보면 보고서에 옮길 수가 없습니다.