

사용자가 「이슈 트래커에서 제 계정은 이 ID예요. 앞으로 내 이슈는 이걸로 찾아 주세요」라고 하면 모델은 「기억하겠습니다」라고 답합니다. 다음 날 새 대화에서 「내 이슈 보여 줘」라고 하면 모델은 계정을 다시 묻거나, 이름이 비슷한 다른 사람의 계정으로 이슈를 찾습니다. LLM API에는 상태가 없어서 대화가 끝나면 그 맥락은 다음 대화로 넘어가지 않습니다. 모델은 기억하겠다고 답했을 뿐 아무것도 저장하지 않았고, 다음 대화까지 남는 것은 시스템이 어딘가에 써 둔 것뿐입니다.
그래서 늘 알아야 할 사실은 사용자마다 텍스트 블록 하나에 적어 매 턴 시스템 프롬프트에 싣습니다. 턴은 질문 하나를 받아 답을 내기까지의 한 번의 질의응답입니다. 모델은 기억하겠다고 답하는 바로 그 턴에 이 블록 전체를 다시 써서 저장합니다. 지난 대화는 따로 저장해 두었다가 모델이 검색할 때만 꺼냅니다. 이 글은 기억을 이 둘로 나눈 기준과, 늘 싣는 블록을 쓰고 고치는 규칙을 다룹니다.
늘 필요한 사실을 검색 뒤에 두면 꺼내지지 않는다
흔한 접근은 대화에서 뽑은 사실을 모두 검색용 저장소에 쌓고, 질문과 비슷한 기억을 찾아 프롬프트에 싣는 것입니다. 양에 제한이 없다는 장점이 있습니다. 문제는 늘 필요한 사실이 질문과 닮지 않았을 때입니다. 「지난주 배포 건 중에 내가 맡은 것 정리해 줘」에는 계정 ID와 닮은 말이 하나도 없지만, 담당 이슈를 찾으려면 그 계정이 있어야 합니다. 검색이 꺼내 주지 않으면 모델은 계정을 모르는 채로 답을 만듭니다. 반대로 지난 대화를 전부 프롬프트에 실으면 컨텍스트 윈도우가 금방 넘칩니다.
그래서 성격이 다른 두 기억을 다른 길로 모델에 보냅니다.
| 개인 메모리 | 지난 대화 | |
|---|---|---|
| 담는 것 | 사용자의 선호·호칭·외부 시스템 계정처럼 짧고 오래가는 사실 | 예전 질문과 답의 원문 |
| 단위 | 사용자당 자유 텍스트 블록 하나 | 턴을 나눈 청크 여러 개 |
| 쓰는 쪽 | 모델(메모리 쓰기 도구), 사용자 본인(설정 화면) | 턴이 끝나면 백그라운드 작업이 자동으로 |
| 모델에 닿는 방식 | 매 턴 시스템 프롬프트에 항상 | 모델이 대화 검색 도구를 불렀을 때만 |
| 상한 | 4,000자 | 청크 4,000자, 턴당 10개 |
개인 사실은 모두 늘 싣는 블록 하나에 둡니다. 실운영 환경 관측에서 가장 긴 블록도 500자가 안 됐습니다. 늘 싣는 블록에 자리가 넉넉히 남으니, 개인 사실을 늘 싣는 쪽과 검색할 쪽으로 다시 나눌 이유가 없습니다.
데이터에 관한 사실은 테이블 메모(「대화에서 바로잡은 컬럼 뜻, 테이블 메모로 다음 사람에게 싣기」)와 조직 용어집·개인 용어집(「부서마다 다른 매출 계산식, 승인된 용어집 정의만 질문 앞에 싣는다」)이 맡고, 조직 사이의 격리는 「조직 경계는 RLS가 지키고, 지울 테이블은 분류표가 정한다」에서 다룹니다.

개인 메모리 블록은 첫 메시지가 아니라 시스템 프롬프트에 싣는다
블록을 대화의 첫 사용자 메시지에 끼워 넣는 방법도 있습니다. 시스템 프롬프트를 고른 이유는 두 가지입니다.
하나는 대화 압축입니다. 긴 대화가 컨텍스트 윈도우에 가까워지면 압축이 오래된 턴을 요약하거나 덜어 냅니다. 압축은 대화 기록만 줄이고 시스템 프롬프트는 건드리지 않습니다. 블록이 첫 메시지에 있으면 오래 이어진 대화일수록 요약 속에서 뭉개지거나 잘려 나갑니다.
다른 하나는 최신성입니다. 시스템 프롬프트는 턴마다 다시 조립됩니다. 다른 대화에서 블록을 고치면 지금 대화의 다음 턴에 바로 반영됩니다.
블록 머리말에는 지금 글자 수와 상한을 함께 적습니다. 블록을 실을 때는 보이지 않는 문자를 걷어 냅니다. 모델이 문서나 웹 페이지에서 읽은 문장을 시스템 프롬프트로 옮겨 적을 수 있는 길이 이 블록뿐이기 때문입니다.
기억하겠다고 답하는 턴에 저장까지 한다
채팅 에이전트의 기본 시스템 프롬프트에 이 간극을 직접 적었습니다. 사용자가 불러 달라는 호칭을 알려 주거나 고쳐 주면 같은 턴 안에 메모리 쓰기 도구로 기록하라고 지시하고, 이유도 함께 적습니다. 기억하겠다는 말만으로는 아무것도 남지 않고, 저장하지 않으면 대화가 끝날 때 사라져 사용자가 같은 말을 다시 해야 한다는 것입니다.
외부 시스템 계정에는 조건이 더 붙습니다. 모델은 그 서비스의 현재 사용자 조회 도구가 돌려준 값이나, 로그인 주소 전체를 그대로 키로 쓴 조회로 확인한 계정만 개인 메모리에 적습니다. 추측한 ID나 철자가 비슷한 ID는 적지 않습니다. 한번 적힌 계정은 이후 모든 대화에서 「내 이슈」를 해석하는 근거가 되므로, 틀리게 적히면 남의 이슈를 내 것처럼 보여 주는 오류가 오래 남습니다.
도구 설명은 적지 말아야 할 것도 정합니다. 특정 날짜, 특정 티켓, 한 번의 질문에 묶인 내용은 넣지 않습니다. 이 블록은 앞으로의 모든 대화에 실리므로, 「이번 주는 A 프로젝트에 집중」 같은 문장은 사실이 아니게 된 뒤에도 계속 사실처럼 실립니다.
고칠 때는 블록 전체를 다시 쓴다
개인 메모리를 고치는 도구는 하나이고 인자도 블록 하나입니다. 모델은 원하는 최종 블록 전체를 보냅니다.
한 줄씩 덧붙이는 도구는 호출이 가볍고 의도가 분명하지만, 기존 내용을 보지 않습니다. 비슷한 문장이 조금씩 다르게 쌓이고, 시점에 묶인 문장은 지워지지 않고 남습니다. 전체를 다시 쓰게 하면 모델은 이미 눈앞에 있는 블록을 읽고, 고치고, 다시 씁니다. 중복을 합치고 낡은 줄을 빼는 일이 같은 쓰기 안에서 일어납니다. 도구 설명도 추가하려는 내용을 다루는 줄이 이미 있으면 새 줄을 더하지 말고 그 줄을 고치라고 합니다.
전체 다시 쓰기의 위험은 남겨야 할 줄을 실수로 떨어뜨리는 것입니다. 이것은 막지 않고 드러냅니다. 도구 결과는 저장된 블록과 함께 이번 쓰기에서 빠진 줄과 더해진 줄을 돌려주고, 모델은 빠진 줄을 보고 의도한 삭제였는지 확인합니다.
경계 동작은 세 가지를 정해 두었습니다.
- 빈 블록을 보내면 저장하지 않고 기존 내용을 그대로 둔 채 경고를 돌려준다. 전체 다시 쓰기에서 빈 문자열은 「모두 삭제」와 같은데, 그 뜻이 모델의 실수로 실행되면 안 된다.
- 전부 지우는 일은 따로 있는 삭제 동작으로만 하고, 지우면 행 자체를 없앤다. 「기억 없음」이 빈 블록 행과 행 없음, 두 모양으로 갈리지 않게 하려는 것이다.
- 동시에 쓰면 나중에 저장한 쪽이 이긴다.
마지막 항목에는 버전 값을 비교하는 낙관적 락이라는 대안이 있습니다. 갱신 분실을 저장 단계에서 막는다는 점에서 더 엄밀합니다. 그런데 실운영 환경에서 개인 메모리 쓰기는 수천 턴에 몇 번꼴이었습니다. 드문 충돌을 막자고 모델이 매번 버전 값을 들고 다니게 하는 비용이 더 컸습니다.
모든 쓰기는 감사 기록에 남습니다. 도구와 설정 화면이 각자 남기지 않고 저장소가 한곳에서 남기며, 쓰는 쪽이 모델인지 사용자 본인인지를 반드시 받습니다. 다시 쓰기는 바뀐 줄만 길이를 잘라 남기고, 전체 삭제는 몇 줄을 지웠는지만 남깁니다. 사용자가 지운 내용을 감사 기록에 그대로 두면 그 삭제가 거짓이 되기 때문입니다.
상한은 글자 수 4,000자 하나이고, 넘으면 거부한다
상한을 넘는 블록은 잘라서 저장하지 않고 거부합니다. 조용히 자르면 블록 끝의 내용이 아무도 모르게 사라집니다. 거부 경고를 받은 모델은 줄을 합치거나 덜어서 다시 씁니다. 언제 정리할지는 모델이 머리말의 글자 수를 보고 정합니다.
저장은 형식 없는 텍스트라서 「줄 하나 = 항목 하나」는 약속이 아니라 관행일 뿐입니다. 모델이 마크다운 제목 줄을 넣으면 그 줄도 항목 하나로 세어집니다. 셀 수 없는 것을 세는 대신 글자 수만 잽니다.
글자 수는 저장 상한을 판정할 때, 프롬프트 머리말에 적을 때, 설정 화면에 보일 때 모두 앞뒤 공백을 벗기고 같은 방식으로 셉니다. 셈법이 다르면 모델이 붙인 끝 줄바꿈 하나로 화면과 프롬프트의 숫자가 갈리고, 어느 쪽이 맞는지 가릴 수 없습니다.
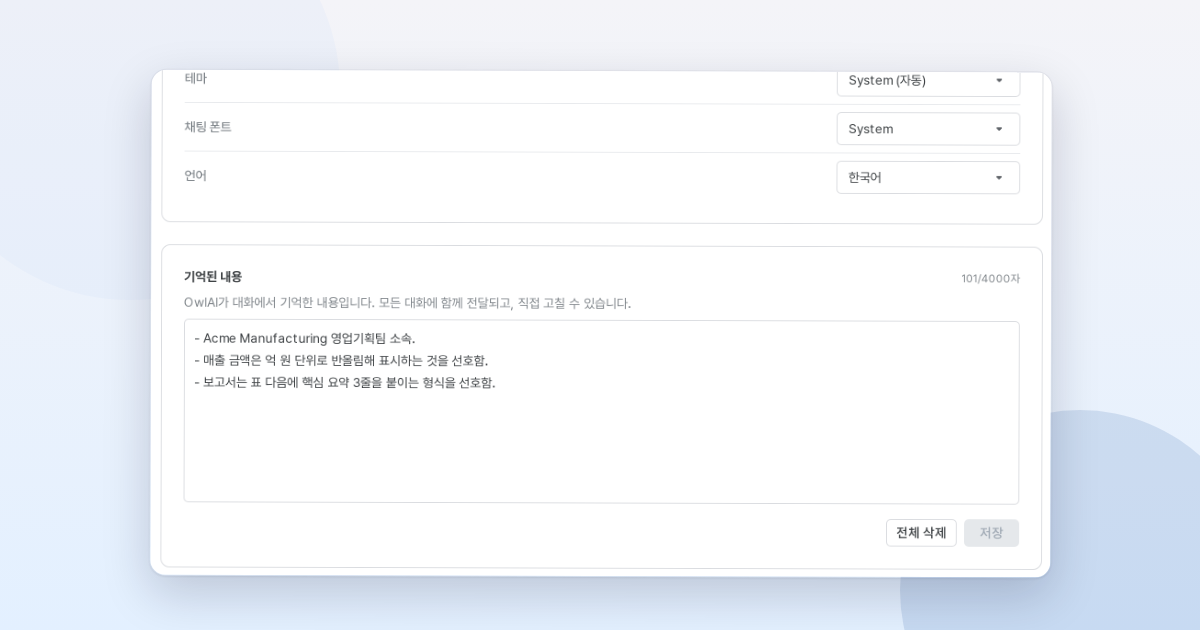
사용자는 프롬프트에 실리는 원문을 설정에서 직접 고친다
이 블록은 매 턴 사용자의 이름으로 모델에게 전달됩니다. 그래서 설정의 기억된 내용에서 블록 원문을 그대로 보여 주고, 사용자가 직접 고치거나 새로 적게 했습니다. 화면에 보이는 문자열이 곧 프롬프트에 실리는 문자열입니다. 화면에서 저장할 때도 도구와 같은 저장 함수, 같은 상한 판정을 거칩니다.
설정 화면은 몇 분씩 열려 있을 수 있고, 그사이 다른 대화에서 모델이 블록을 바꿀 수 있습니다. 서버는 나중에 저장한 쪽을 받으므로 이 충돌은 화면이 맡습니다.
- 저장을 누르면 화면이 서버 내용을 다시 읽어 편집을 시작할 때의 내용과 비교한다.
- 다르면 저장하지 않고 「다른 곳에서 기억된 내용이 바뀌었습니다」라고 알린다. 편집 중인 글은 그대로 둔다.
- 저장을 한 번 더 누르면 편집본으로 덮어쓰고, 서버 내용 불러오기를 누르면 편집을 버리고 최신 내용을 받는다.
글상자를 비운 채 저장하면 저장하지 않고 전체 삭제를 쓰라고 안내합니다. 전체 삭제는 확인 창을 한 번 더 거치고, 되돌릴 수 없습니다.
지난 대화는 검색 도구를 부를 때만 꺼낸다
턴이 끝나면 백그라운드 작업이 그 턴의 질문과 답을 4,000자 단위 청크로 나눠 저장합니다. 경계는 공백 자리로 당겨서 낱말이 두 청크에 반쪽씩 갈리지 않게 하고, 한 턴은 청크 10개(40,000자)까지 색인합니다. 이 과정에 LLM은 쓰지 않습니다. 턴마다 요약을 만들면 그 비용이 매번 들고, 요약에서 빠진 낱말로는 나중에 그 대화를 찾을 수 없습니다.
저장한 청크는 프롬프트에 자동으로 실리지 않습니다. 모델이 대화 검색 도구를 부르면 키워드 검색과 의미 검색을 함께 돌려 그 사용자의 청크에서 찾아 돌려줍니다. 한 턴에서는 가장 잘 맞는 청크 하나만 남겨서, 긴 턴 하나가 검색 결과를 다 채우지 않게 합니다. 관련 있어 보이는 청크를 매 턴 미리 싣지 않는 이유는, 대부분의 턴에는 지난 대화가 필요 없고 무관한 청크가 지금의 답을 흐리기 때문입니다. 「저번에 짠 그 매출 쿼리」처럼 앞의 대화를 가리키는 질문이 오면 모델이 그것을 알아차리고 찾으러 가는 편이 더 정확합니다.
검색 범위는 그 사용자 본인으로 고정됩니다. 신원을 확인하지 못하면 검색을 하지 않고 빈 결과를 돌려줍니다. 사용자가 지운 대화의 청크는 실제로 삭제되기 전이라도 검색에서 빠집니다.
설계에서 고른 것
개인 메모리는 검색하지 않고 매 턴 싣습니다. 늘 필요한 사실이 질문과 닮지 않아도 빠지지 않는다는 것이 이유이고, 블록 크기만큼의 토큰을 매 턴 내는 것이 대가입니다. 그래서 상한을 4,000자로 묶었습니다. 블록이 바뀔 때 프롬프트 캐시에 생기는 일은 「시스템 프롬프트 한 줄에 캐시 읽기가 0이 된다, 바뀌는 블록은 뒤로 보낸다」에서 다룹니다.
무엇을 기억할지는 시스템 프롬프트로 모델에게 맡겼습니다. 같은 문장도 대화 맥락을 봐야 기억할 일인지 정해지기 때문입니다. 그 판단이 빗나갈 수 있다는 대가는 사용자가 설정에서 블록을 언제든 보고 고치는 것으로 받습니다.
편집은 전체 다시 쓰기 하나로 좁혔고, 줄이 떨어질 위험은 도구 결과에 빠진 줄을 드러내는 것으로 받습니다. 동시 쓰기의 갱신 분실은 서버에서 막지 않았습니다. 쓰기가 드문 모델 쪽은 나중에 저장한 쪽이 이기게 두고, 몇 분씩 열려 있는 설정 화면만 저장 직전 비교로 충돌을 잡습니다.
지난 대화는 검색 도구로만 꺼냅니다. 매 턴 싣는 비용이 없는 대신, 모델이 찾으러 가야만 꺼내집니다.
이 설계는 기억할 내용이 한 사람의 선호, 호칭, 외부 계정처럼 짧고 오래가는 사실일 때 맞습니다. 블록이 상한 안에서 매 턴 실려야 「읽고, 고치고, 다시 쓰기」가 성립합니다. 사용자마다 기억할 사실이 수천 자를 넘는 환경이라면 블록에 둘 사실과 검색으로 꺼낼 사실을 먼저 나눠야 합니다.
어떤 문제를 해결하나요?
인사이트 · 쓸수록 나아지는 AI
매번 붙이는 보고서 조건, AI가 기억하게 할 수 있을까
AI에게 보고서 초안을 부탁할 때마다 같은 조건을 붙입니다.
인사이트 · 쓸수록 나아지는 AI
지난 대화에서 정한 기준을 AI가 이어 쓸 수 있을까
지난주 AI와 한참 이야기한 끝에 거래처별 미수금을 어떻게 조회할지 정리했습니다. 오늘 비슷한 숫자가 다시 필요한데 그 대화가 어디 있는지 기억나지 않습니다.
인사이트 · 쓸수록 나아지는 AI
담당자 머릿속에만 있던 데이터 규칙, 그 사람이 떠나도 AI는 기억할까
어느 회사에나 데이터의 함정을 아는 고참이 있습니다.
메모리와 검색의 다른 글
엔지니어링 노트 · 메모리와 검색
대화에서 바로잡은 컬럼 뜻, 테이블 메모로 다음 사람에게 싣기
고객 테이블의 상태 컬럼 STATCD 에는 1, 2, 9가 들어 있습니다. 스키마만 봐서는 9가 해지라는 것을 알 수 없어서, 「활성 고객 수」를 물으면 모델은 해지 고객까지 세어 보고서에 올립니다.
엔지니어링 노트 · 메모리와 검색
조사 붙은 검색어는 전문 검색에 안 걸린다, 낱말을 OR로 잇는다
테이블 메모에 「반품 주문은 ORDRTN 테이블에 따로 쌓인다」라고 적혀 있고, 사용자가 「지난달 반품 주문 건수를 알려 줘」라고 묻습니다.
엔지니어링 노트 · 메모리와 검색
시스템 프롬프트 한 줄에 캐시 읽기가 0이 된다, 바뀌는 블록은 뒤로 보낸다
에이전트가 모델을 부를 때마다 요청에는 도구 정의, 시스템 프롬프트, 그때까지의 대화 맥락이 이 순서로 실립니다.